Bagi setiap insinyur sistem, administrator pusat data, dan teknisi perangkat keras enterprise, insiden kegagalan komponen fisik pada peladen (server) adalah bagian tak terhindarkan dari rutinitas operasional sehari-hari. Mulai dari server yang mendadak mati sendiri di tengah malam, sistem operasi yang membeku total dengan pesan kernel panic, hingga lampu indikator sasis yang berkedip-kedip dengan warna kuning peringatan (amber error LED). Dalam situasi krisis di mana downtime layanan bisnis sedang berlangsung, menebak-nebak komponen mana yang rusak secara serampangan adalah tindakan amatir yang dapat memperburuk masalah.
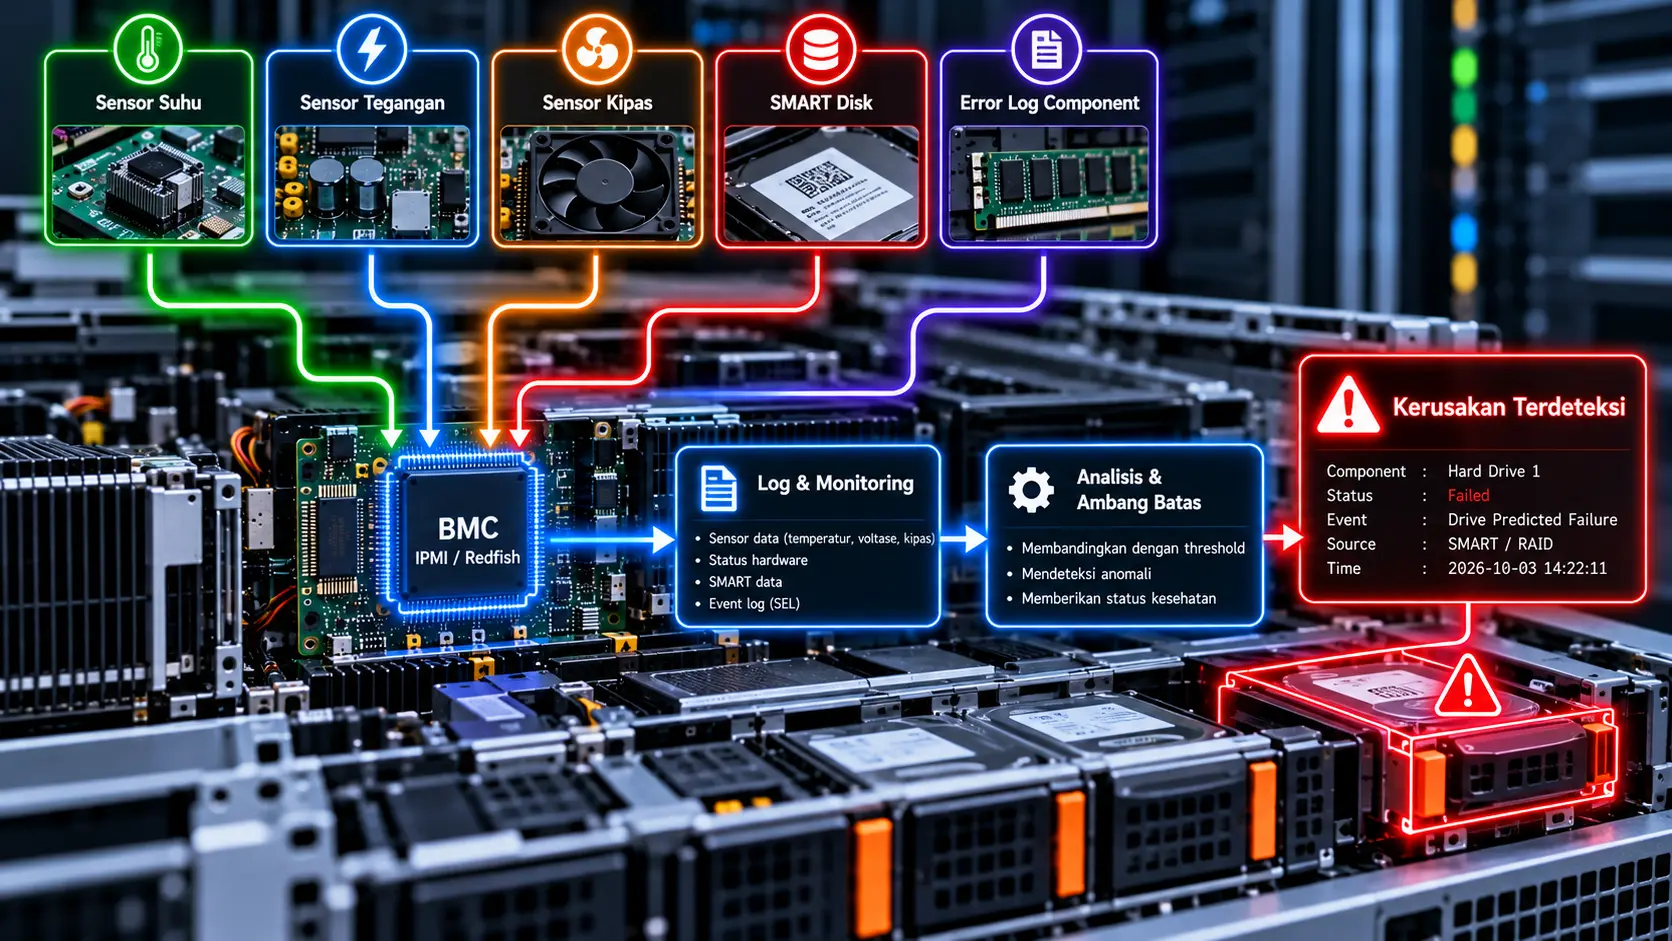
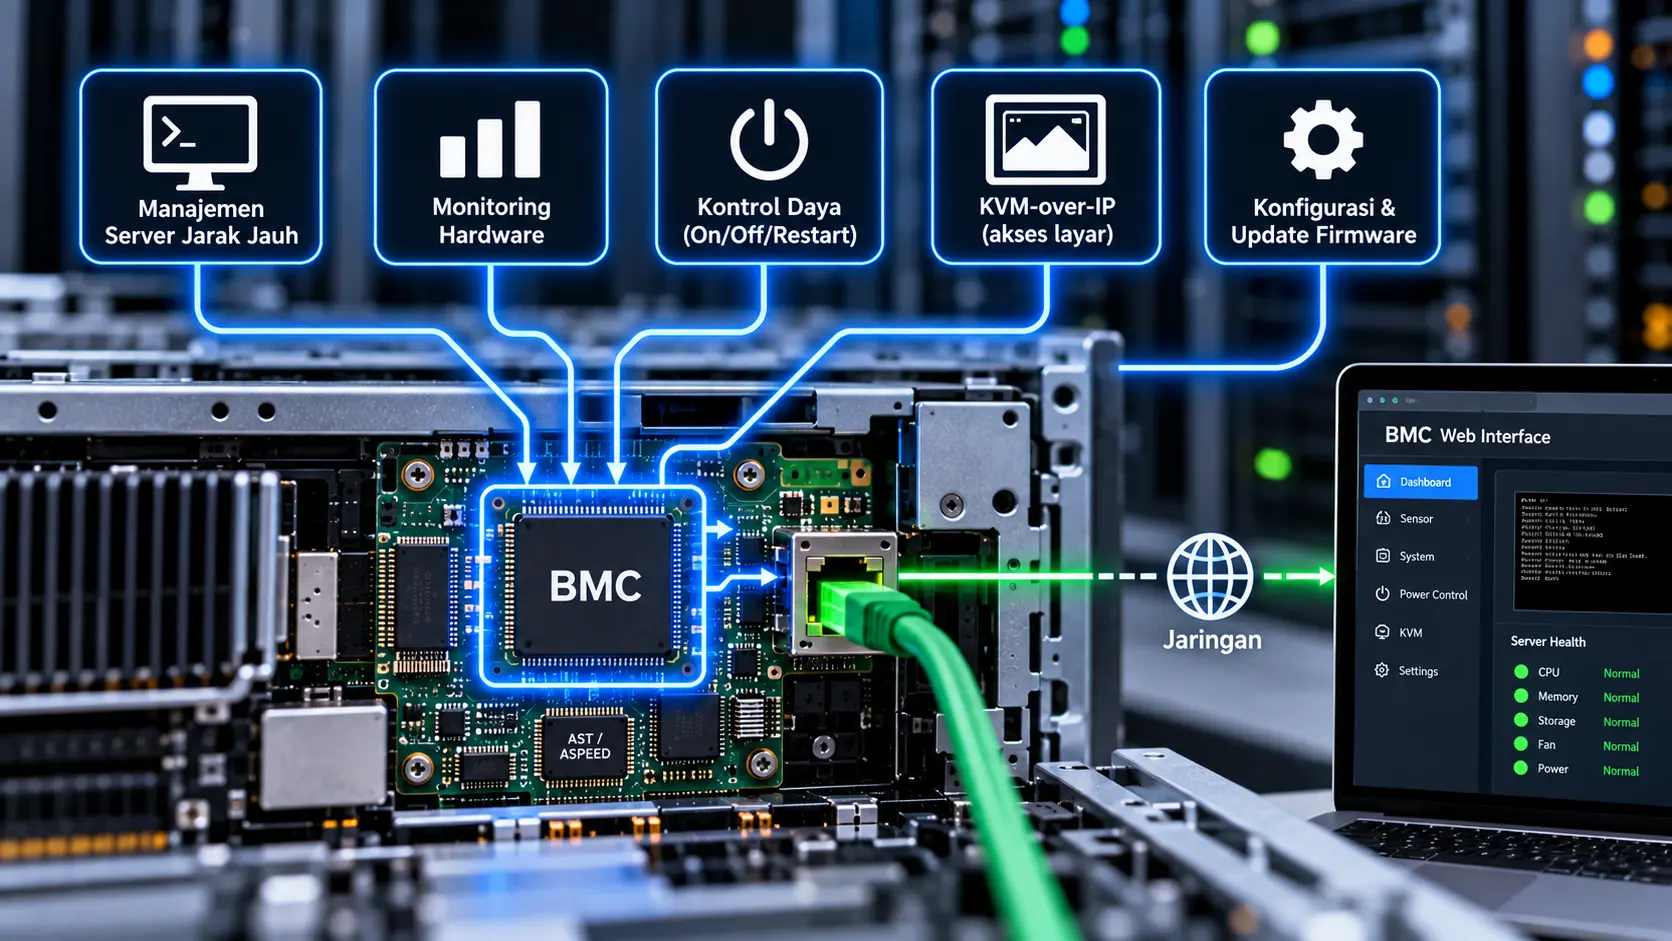
Peladen kelas enterprise—seperti lini Dell PowerEdge, HPE ProLiant, Lenovo ThinkSystem, atau Supermicro—dirancang dengan instrumen diagnostik mandiri yang sangat canggih. Setiap detik, mikrokontroler manajemen independen (Baseboard Management Controller / BMC) memindai ratusan titik sensor perangkat keras di seluruh sasis. Ketika terjadi anomali kelistrikan, lonjakan suhu, kesalahan paritas memori, atau kegagalan mekanis, server tidak sekadar mengalami crash; server mendokumentasikan catatan kronologis autopsi insiden tersebut ke dalam repositori log perangkat keras yang sangat terperinci.
Namun, bagi mereka yang belum terbiasa, membaca log perangkat keras server sering kali terasa membingungkan karena dipenuhi oleh singkatan teknis elektro, kode heksadesimal, indeks sensor abstrak, dan terminologi standar industri tingkat rendah. Menguasai metodologi bagaimana membaca log hardware server secara tepat adalah keterampilan paling fundamental yang memisahkan seorang operator IT biasa dari seorang spesialis infrastruktur enterprise yang mampu menemukan akar masalah (Root Cause Analysis / RCA) hanya dalam hitungan menit.
Sumber Log Hardware Utama: System Event Log (SEL) dan Pengawasan Out-of-Band
Langkah pertama dalam investigasi kegagalan server adalah memahami di mana log perangkat keras sebenarnya disimpan dan bagaimana cara mengaksesnya secara aman:
1. Repositori Non-Volatile: System Event Log (SEL)
Log perangkat keras server tingkat paling fundamental disimpan di dalam memori non-volatile chip Baseboard Management Controller (BMC) yang disebut System Event Log (SEL). Berbeda dengan berkas log sistem operasi (seperti Event Viewer di Windows atau /var/log/messages di Linux) yang akan terhenti pencatatannya jika sistem operasi mengalami crash, SEL beroperasi secara out-of-band di bawah sistem operasi tertanam mandiri BMC. SEL tetap mencatat kronologi peristiwa listrik bahkan saat server dalam kondisi mati total (standby power), menjadikannya saksi bisu paling objektif terhadap detik-detik terjadinya kegagalan fisik.
2. Cara Mengakses SEL: Web GUI, IPMI CLI, dan Redfish API
Administrator dapat mengekstraksi isi log SEL melalui berbagai metode antarmuka:
– Antarmuka Web Grafis Konsol Manajemen: Masuk ke portal web out-of-band server (seperti Dell iDRAC pada menu ‘Maintenance -> System Event Log’, HPE iLO pada menu ‘Logs -> Integrated Management Log / IML’, atau Lenovo XCC pada menu ‘Events’). Antarmuka grafis ini secara otomatis menerjemahkan kode mentah heksadesimal menjadi teks deskriptif yang mudah dibaca oleh manusia.
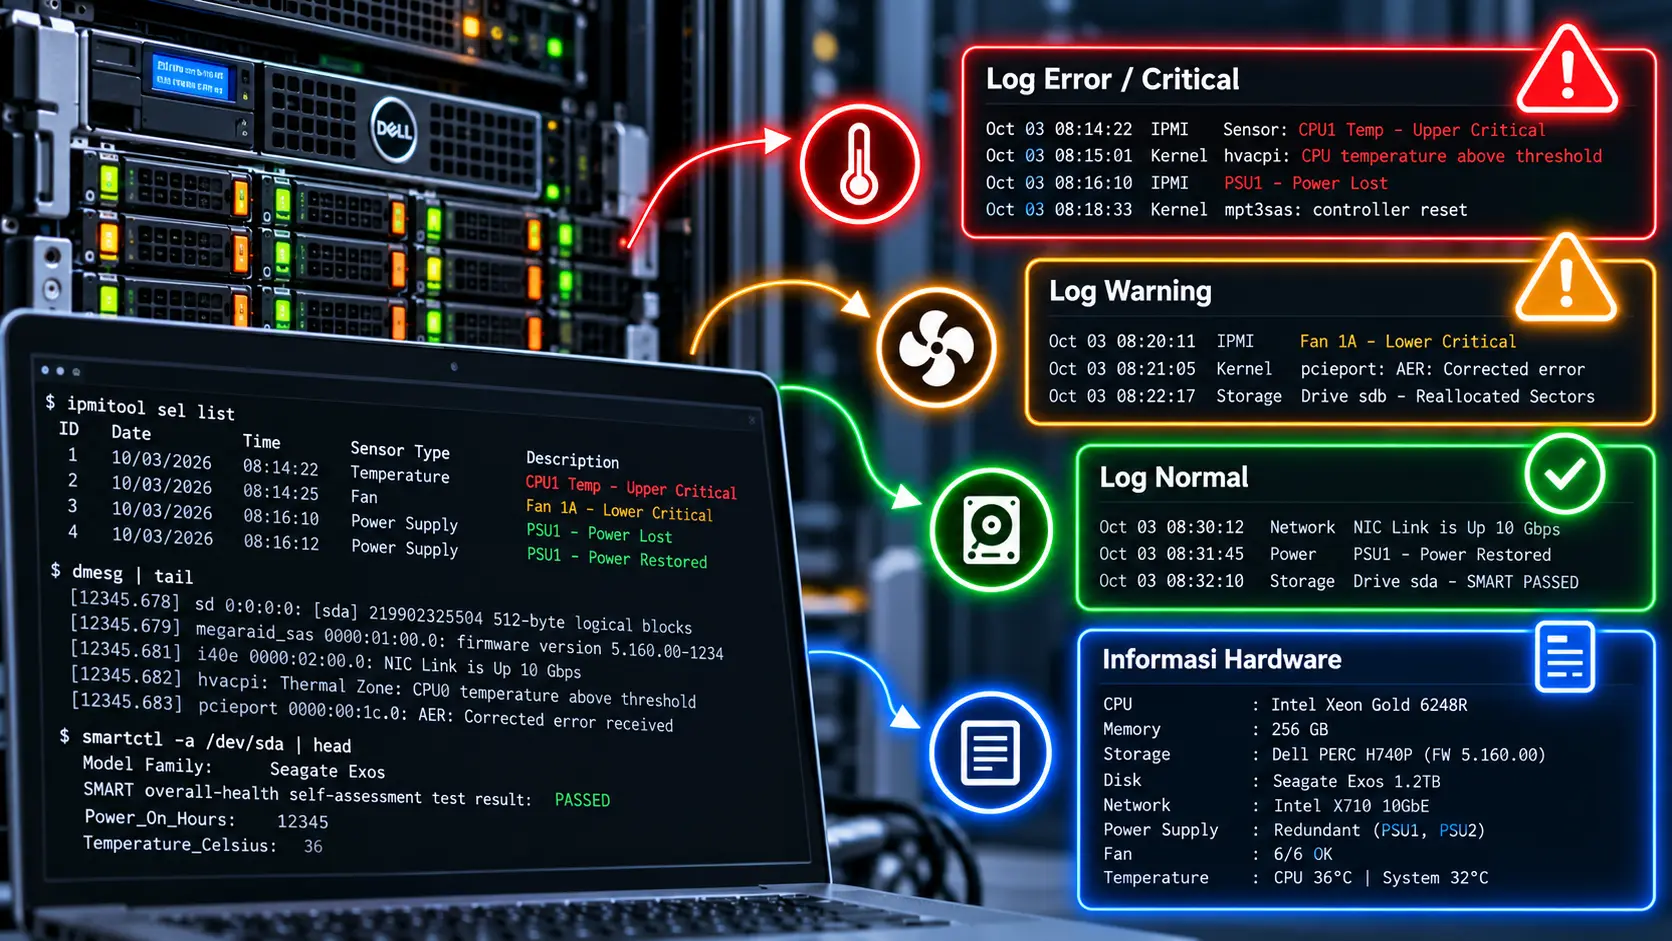
– Baris Perintah IPMItool (CLI): Menggunakan utilitas standar industri ipmitool dari terminal Linux untuk membaca log secara cepat tanpa peramban web: ipmitool sel list (untuk menampilkan ringkasan log) atau ipmitool sel elist (untuk menampilkan detail deskripsi peristiwa beserta nama sensor terkait).
Anatomi Struktur Entri Log SEL: Membedah Elemen-Elemen Standar
Sebuah entri mentah di dalam System Event Log IPMI umumnya memiliki format baris terstruktur yang memuat lima komponen data esensial:
Contoh entri log IPMI:
0042 | 10/21/2026 | 08:14:22 | Memory #0x2B | Correctable ECC (@DIMM_B1) | Asserted
Mari kita bedah anatomi dari baris log di atas:
1. Record ID (0042): Nomor urut kronologis heksadesimal dari peristiwa yang tercatat di dalam basis data SEL.
2. Timestamp (10/21/2026 08:14:22): Waktu kejadian presisi yang disinkronkan dengan jam internal BMC (Real-Time Clock / RTC) atau server waktu NTP jaringan data center.
3. Sensor Type and Number (Memory #0x2B): Mengidentifikasi jenis subsistem perangkat keras yang melaporkan anomali. Angka heksadesimal 0x2B adalah alamat bus perangkat keras unik dari sensor tersebut di motherboard.
4. Event Description (Correctable ECC @DIMM_B1): Deskripsi kondisi anomali yang terjadi. Bagian ini secara spesifik menyebutkan jenis insiden (kesalahan bit yang berhasil dikoreksi) dan lokasi fisik komponen (slot memori DIMM B1 pada soket prosesor 2).
5. Event Direction / Status (Asserted vs Deasserted): Status ‘Asserted’ menunjukkan bahwa kondisi kesalahan atau batas ambang bahaya sedang aktif terjadi saat itu. Status ‘Deasserted’ menunjukkan bahwa kondisi kesalahan telah mereda atau sensor telah kembali ke rentang batas normal (misalnya suhu kembali dingin).
Kategori Peristiwa Hardware yang Paling Sering Muncul dan Cara Mengartikannya
Membaca log perangkat keras membutuhkan pemahaman mengenai interpretasi di balik pesan-pesan diagnostik umum berikut ini:
1. Anomali Subsistem Memori (Memory Subsystem Events)
– ‘Correctable ECC logging limit reached’: Menandakan bahwa sebuah modul RAM mengalami kesalahan single-bit error berulang kali dalam frekuensi tinggi hingga melampaui batas ambang batas pelaporan. Ini adalah sinyal peringatan dini (predictive failure) bahwa modul RAM di slot tersebut sedang menuju kerusakan permanen dan harus segera diganti.
– ‘Uncorrectable ECC error / Multi-bit error detected’: Menandakan terjadinya tabrakan bit memori yang parah dan tidak dapat diperbaiki oleh algoritma ECC. Peristiwa ini hampir selalu berujung pada crash sistem operasi instan guna melindungi data pangkalan data dari korupsi. Solusi: Catat nomor slot DIMM yang tertera dan ganti modul tersebut.
2. Anomali Subsistem Catu Daya (Power Supply Events)
– ‘Power Supply Redundancy Lost’: Menandakan server kehilangan status toleransi kegagalan catu daya. Periksa entri log sebelumnya untuk melihat apakah salah satu modul PSU mengalami ‘Input Lost’ (kabel listrik terlepas atau gardu listrik padam) atau ‘Predictive Failure’ (kipas internal PSU mati atau sirkuit mengalami kelebihan panas).
– ‘Power Supply Over-Current / Voltage Degraded’: Mengindikasikan adanya lonjakan penarikan arus listrik abnormal di dalam sasis, sering kali dipicu oleh korsleting pada komponen periferal PCIe atau drive backplane.
3. Anomali Subsistem Termal dan Kipas (Thermal & Fan Events)
– ‘CPU Thermal Trip / Critical Temperature Exceeded’: Sensor termal silikon prosesor mendeteksi suhu inti telah menembus batas batas kritis Junction Temperature (TjMax, biasanya sekitar 100 derajat Celsius). Server secara otomatis mematikan daya secara darurat untuk menyelamatkan prosesor dari kehancuran fisik. Penyebab umumnya adalah pasta termal (thermal paste) yang telah mengering atau pompa cairan pendingin macet.
– ‘Fan Lower Non-Recoverable Threshold’: Menandakan salah satu modul kipas sasis ganda mengalami penurunan kecepatan rotasi di bawah batas minimum aman atau berhenti berputar total akibat kerusakan mekanis motor.
4. Machine Check Exception (MCE) dan Bus Interkoneksi
Pesan log yang memuat kode ‘Machine Check Exception’ (MCE), ‘PCIe Correctable/Uncorrectable Error’, atau ‘Bus Fatal Error’ mengindikasikan adanya kegagalan integritas sinyal berkecepatan tinggi antara prosesor dengan kartu ekspansi PCIe (seperti kartu RAID, kartu jaringan, atau GPU). Log tingkat lanjut biasanya menyertakan alamat Device:Bus:Function (BDF) heksadesimal (misalnya ‘PCIe Fatal Error on B00:D01:F00’) yang dapat dicocokkan dengan tabel pemetaan PCIe di manual teknis motherboard untuk mengidentifikasi kartu fisik mana yang bermasalah.
Alur Kerja Sistematis dalam Mendiagnosis Masalah Melalui Log
Ketika menghadapi peladen enterprise yang bermasalah, terapkan metodologi investigasi berikut secara terstruktur:
Langkah 1: Kumpulkan Bundel Laporan Lengkap (Full Diagnostic Dump): Sebelum melakukan tindakan fisik apapun, ekspor bundel diagnostik lengkap resmi dari konsol manajemen—seperti berkas Technical Support Report (TSR / SupportAssist Collection) pada Dell iDRAC atau Active Health System (AHS Log) pada HPE iLO. Berkas terkompresi ini memuat rekaman telemetri ratusan megabita yang mencakup riwayat voltase mikrodetik sebelum insiden terjadi.
Langkah 2: Telusuri Urutan Kronologis Peristiwa (Trace the Chain of Events): Periksa entri log tepat sebelum server mengalami crash. Sering kali, peristiwa fatal terakhir (misalnya ‘OS Shutdown’ atau ‘System Reset’) hanyalah akibat dari peristiwa pertama yang terjadi beberapa detik sebelumnya (misalnya ‘Voltage Regulator Phase 3 Failed’). Temukan entri berstatus ‘Critical’ yang paling awal muncul dalam garis waktu.
Langkah 3: Lakukan Pengecekan Silang dengan Perubahan Terkini: Cocokkan cap waktu log dengan jadwal pemeliharaan tim IT. Apakah insiden perangkat keras terjadi tepat setelah dilakukan pembaruan firmware, pemasangan kartu ekspansi baru, atau pemindahan kabel di rak data center?
Langkah 4: Eksekusi Tindakan Penggantian Komponen Secara Terarah: Dengan nomor part dan lokasi fisik yang tertera secara akurat pada log (misalnya ‘Fan Module 4’ atau ‘RAID Controller Battery’), teknisi dapat menyiapkan suku cadang pengganti yang tepat dan menjadwalkan jendela pemeliharaan (maintenance window) perbaikan dengan keyakinan keberhasilan 100 persen.
Kesimpulan
Log perangkat keras server enterprise adalah kompas navigasi paling berharga bagi setiap praktisi infrastruktur teknologi informasi. Dengan memahami arsitektur pencatatan out-of-band pada System Event Log (SEL), menguasai cara membaca kode sensor IPMI dan register Machine Check, serta menerapkan metodologi diagnosis berbasis urutan kronologis peristiwa, administrator sistem dapat mentransformasi pesan kesalahan heksadesimal yang rumit menjadi rencana aksi perbaikan perangkat keras yang cepat, tepat sasaran, dan menjamin uptime pusat data korporat di level tertinggi.
Integrasi Pengawasan Log Hardware dengan Ekosistem Monitoring Modern
Di era otomasi pusat data modern yang mengelola ratusan hingga ribuan peladen fisik secara terdistribusi, membaca log perangkat keras secara manual satu per satu melalui antarmuka web GUI lokal bukanlah pendekatan yang efisien. Praktik terbaik industri saat ini adalah mengintegrasikan log hardware out-of-band secara langsung ke dalam platform observabilitas terpusat (Centralized Observability Stack):
1. Pengiriman Log Real-Time Melalui Remote Syslog dan SNMP Traps: Firmware BMC (iDRAC, iLO, XCC) dikonfigurasi untuk secara otomatis meneruskan setiap entri baru di System Event Log (SEL) secara instan ke server pengumpul log terpusat (seperti Elasticsearch, Logstash, Kibana / ELK Stack, Splunk, atau Graylog) menggunakan protokol Syslog over TLS yang aman. Hal ini memastikan bahwa seluruh riwayat kegagalan fisik tersimpan secara permanen bahkan jika chip flash lokal BMC mengalami kegagalan.
2. Otomasi Tiket Insiden Berbasis Redfish Eventing: Menggunakan antarmuka pemrograman aplikasi standar Redfish Server-Sent Events (SSE), sistem manajemen data center dapat mendengarkan notifikasi status perangkat keras secara real-time. Jika terdeteksi peristiwa kritis (misalnya ‘Fan Failure’ atau ‘Disk Predictive Failure’), sistem otomatisasi dapat segera memicu pembuatan tiket perbaikan di sistem manajemen layanan IT (seperti ServiceNow atau Jira Service Management), mengalokasikan suku cadang cadangan dari gudang logistik, dan mengarahkan teknisi ke lokasi rak yang tepat tanpa memerlukan intervensi manusia di tahap pelaporan awal.
Dengan memadukan pembacaan log perangkat keras yang teliti dan sistem otomasi terpusat, tim IT enterprise dapat mentransformasi pendekatan operasional mereka dari reaktif saat insiden terjadi menjadi manajemen infrastruktur yang sepenuhnya proaktif, terukur, dan berstandar kelas dunia.