Dalam arsitektur infrastruktur pusat data enterprise dengan tuntutan operasional tanpa jeda, kegagalan pada komponen fisik peladen (server) adalah sebuah kepastian yang harus selalu diantisipasi. Ketika sebuah server yang melayani jutaan transaksi perbankan atau basis data perdagangan elektronik mengalami mati listrik mendadak, kerusakan motherboard, atau pembekuan sistem operasi, bisnis tidak boleh berhenti menunggu teknisi datang mengganti komponen fisik tersebut. Mekanisme penyelamatan otomatis yang paling fundamental dalam menjaga kelangsungan hidup layanan komputasi adalah apa yang dikenal sebagai proses failover server.
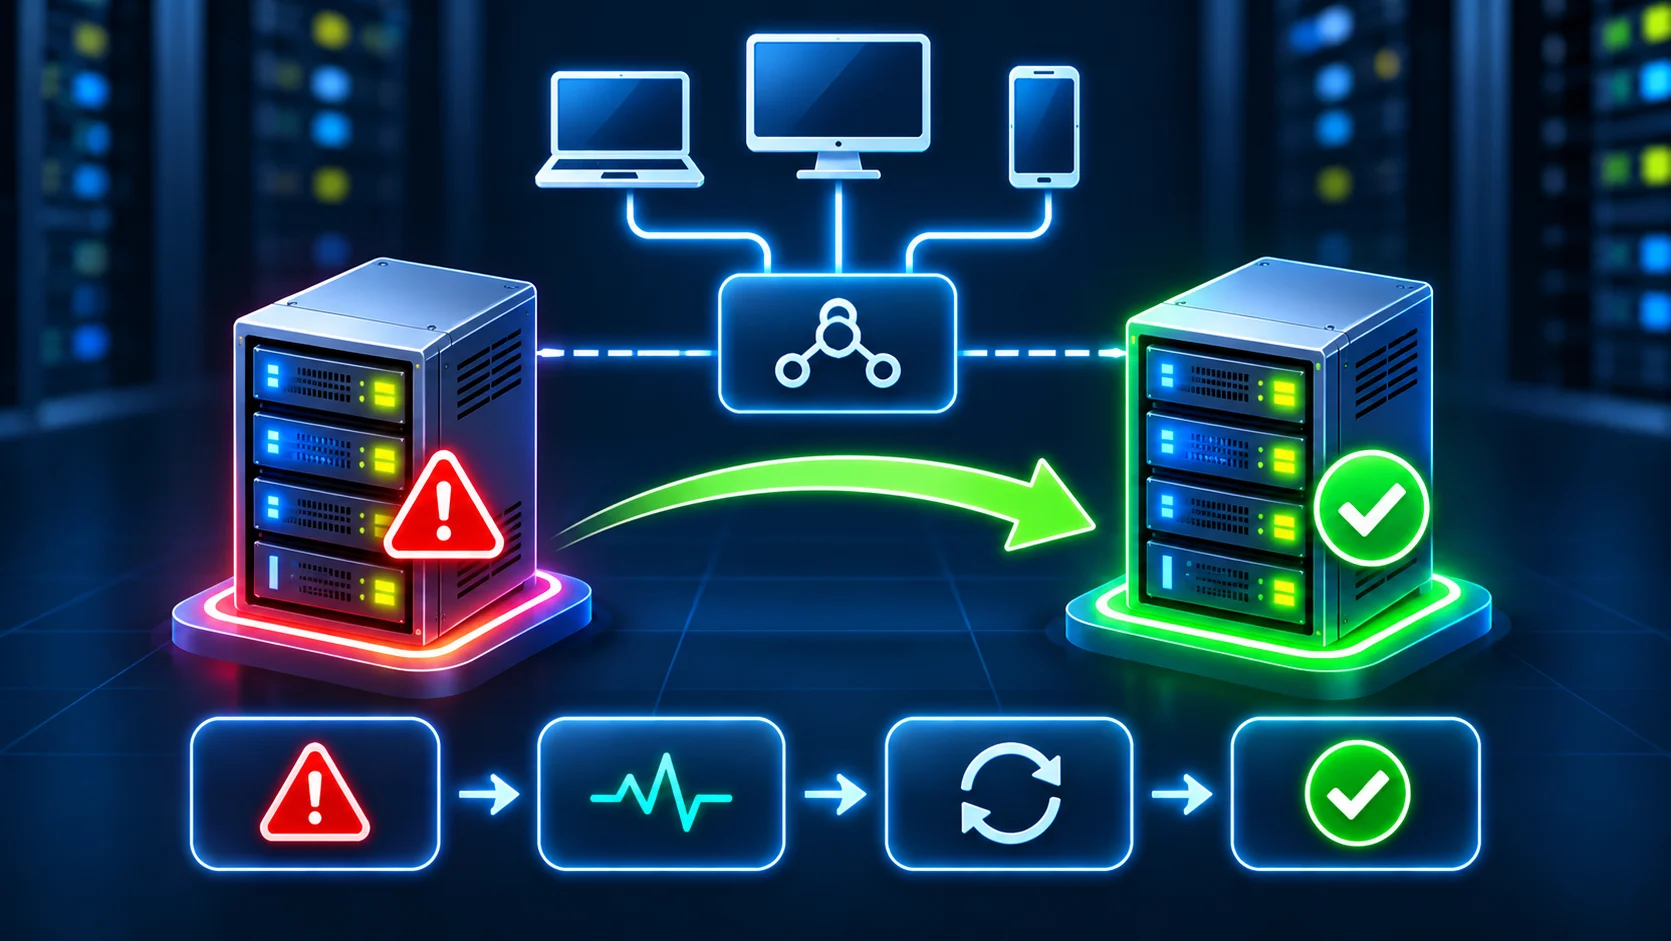
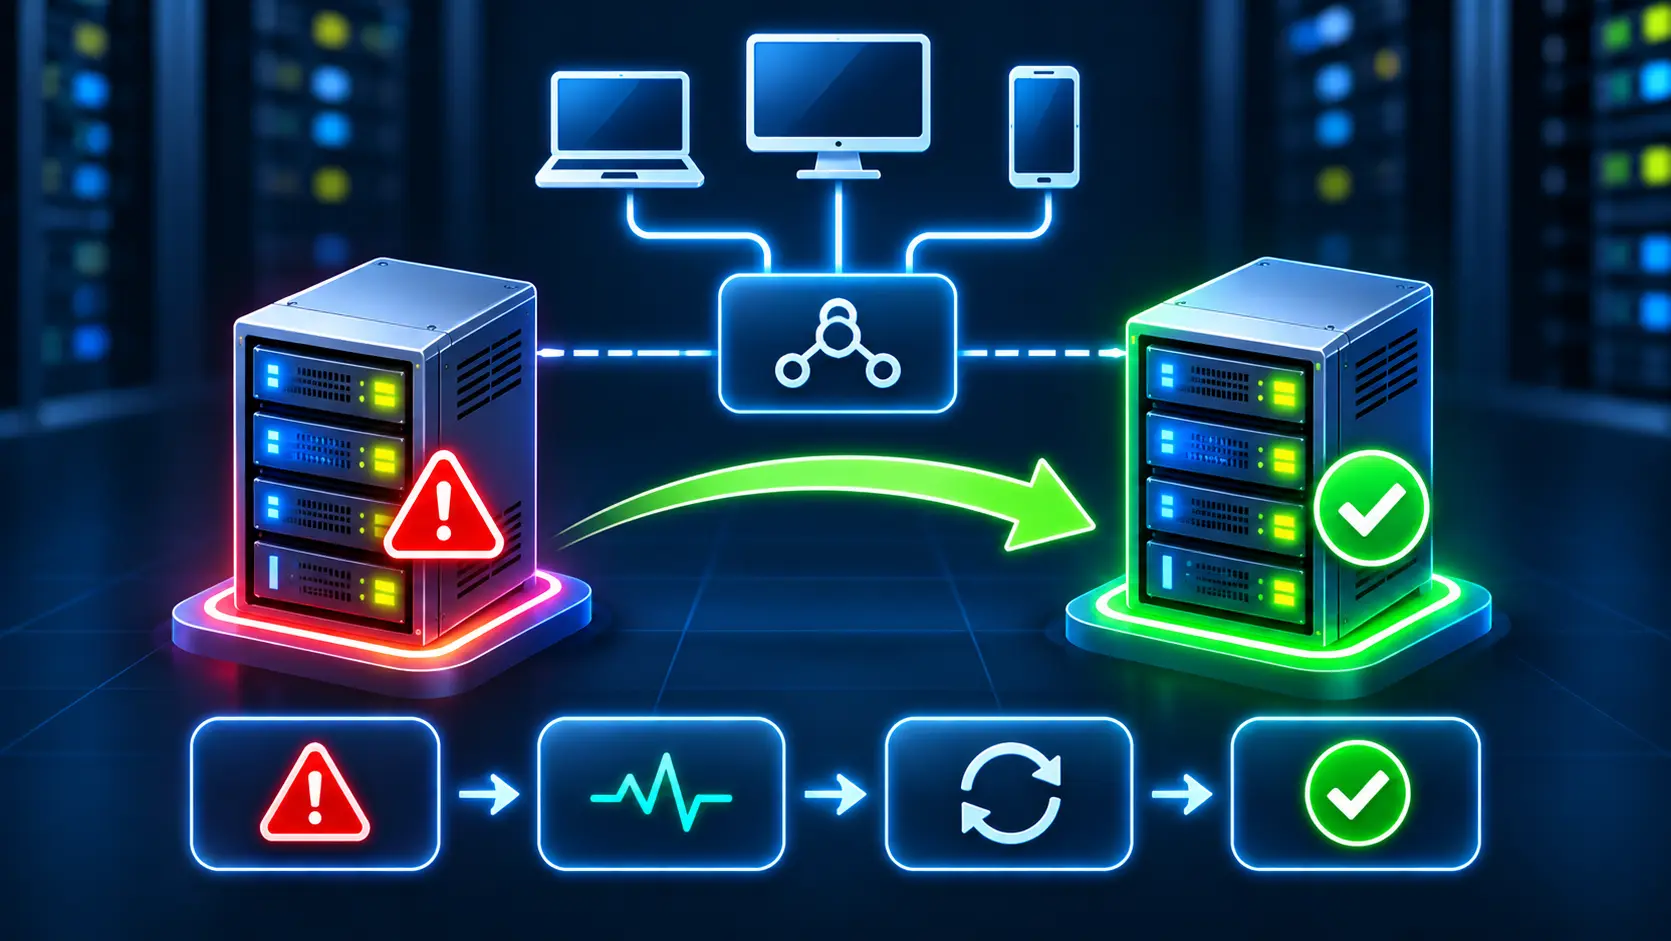
Secara terminologi teknis, failover adalah prosedur pengalihan otomatis seluruh beban kerja komputasi, peran layanan, alamat jaringan, dan akses penyimpanan data dari sebuah sistem atau komponen primer yang mengalami kegagalan (Primary Node) menuju ke sebuah sistem atau komponen sekunder yang siaga sehat (Secondary / Standby Node) tanpa interupsi layanan yang berarti bagi pengguna akhir.
Meskipun konsepnya terdengar sederhana—seperti mengalihkan sakelar lampu dari satu sumber ke sumber lain—eksekusi failover server di balik layar adalah sebuah simfoni rekayasa terdistribusi yang sangat kompleks. Diperlukan koordinasi mikrodetik yang melibatkan deteksi kegagalan berbasis detak jantung (heartbeat failure detection), pelepasan sumber daya secara aman (resource fencing), pengambilalihan alamat IP virtual (VIP migration), penyelarasan status transaksi pangkalan data, hingga pembaruan tabel rute jaringan sakelar data center.
Tahapan Kronologis: Lima Fase Utama dalam Proses Failover Server
Prosedur failover otomatis berlangsung dalam hitungan detik melalui lima fase terstruktur yang dieksekusi oleh perangkat lunak manajemen kluster:
Baca Juga: Apa Itu High Availability Server: Standar Five Nines, Metrik RTO/RPO, dan Arsitektur Tanpa Downtime
Fase 1: Deteksi Kegagalan dan Ambang Batas Waktu Henti (Heartbeat Failure Detection)
Setiap node di dalam kluster memancarkan sinyal detak jantung (heartbeat) secara terus-menerus melalui jaringan terdedikasi setiap beberapa ratus milidetik. Ketika Node Primer mengalami kegagalan fisik (misalnya prosesor terbakar atau pasokan listrik padam total), transmisi paket heartbeat terhenti seketika.
Node Sekunder mendeteksi hilangnya sinyal ini dan memulai penghitungan waktu mundur (countdown timer). Jika sinyal heartbeat tidak kembali dalam batas ambang batas toleransi (missed heartbeat threshold, biasanya berkisar antara 3 hingga 5 detik), Node Sekunder secara resmi mendeklarasikan bahwa Node Primer berada dalam status mati (dead node), memicu inisiasi prosedur failover darurat.
Fase 2: Isolasi Perangkat Keras dan Fencing (STONITH Isolation)
Sebelum Node Sekunder diizinkan mengambil alih layanan dan mengakses data bisnis, Node Sekunder wajib memastikan bahwa Node Primer benar-benar mati dan tidak akan pernah mencoba menulis data lagi (mencegah fenomena split-brain):
Node Sekunder mengirimkan perintah isolasi daya fisik (Fencing / STONITH) langsung ke Baseboard Management Controller (BMC/iDRAC/iLO) atau smart PDU milik Node Primer untuk mematikan aliran listriknya secara paksa. Setelah konfirmasi pemutusan daya fisik diverifikasi secara kriptografis, hak kepemilikan volume penyimpanan bersama (shared storage) dilepaskan sepenuhnya dari Node Primer.
Fase 3: Pengambilalihan Alamat Jaringan Virtual (Virtual IP Migration)
Agar ribuan aplikasi klien dan pengguna di internet tidak kehilangan arah, kluster menggunakan mekanisme Virtual IP (VIP) takeover:
Node Sekunder mengikatkan alamat IP virtual layanan ke kartu jaringan fisiknya sendiri, lalu menyiarkan paket gratuitous ARP (GARP) secara masif ke seluruh sakelar jaringan (switches) dan router di pusat data. Paket ini memaksa sakelar jaringan memperbarui tabel pemetaan MAC address mereka dalam hitungan milidetik, sehingga seluruh paket data dari pengguna yang sedang berjalan seketika dialihkan ke Node Sekunder tanpa perlu mengubah konfigurasi DNS klien.
Fase 4: Pemasangan Sistem Penyimpanan dan Pemulihan Status Basis Data
Node Sekunder memasang (mounting) partisi penyimpanan data (shared disk LUN atau volume tereplikasi) ke dalam sistem operasinya. Pada layanan basis data transaksional (seperti Microsoft SQL Server, Oracle RAC, atau PostgreSQL):
– Engine basis data sekunder memuat log transaksi terakhir (transaction logs / write-ahead logs).
– Seluruh transaksi yang telah dikomit (committed transactions) sebelum insiden terjadi dipastikan tersimpan aman ke disk.
– Transaksi yang masih menggantung atau belum selesai saat server primer mati secara otomatis dibatalkan (rolled back) untuk menjamin konsistensi ACID (Atomicity, Consistency, Isolation, Durability) pangkalan data.
Fase 5: Peluncuran Layanan dan Penyelesaian Sesi Klien (Service Startup)
Daemon layanan aplikasi (seperti Apache, NGINX, atau ERP enterprise) diaktifkan secara penuh pada Node Sekunder. Pengguna yang sedang aktif mungkin hanya merasakan jeda waktu pembekuan (latency spike) selama 1 hingga 3 detik saat failover berlangsung, setelah itu aplikasi dapat digunakan kembali secara normal seolah-olah tidak pernah terjadi insiden kerusakan apa pun.
Dua Model Utama Failover: Statefull vs Stateless Failover
Berdasarkan cara penanganan data sesi pengguna di memori, arsitektur failover dibagi menjadi dua kategori teknis:
1. Stateless Failover (Pengalihan Layanan Tanpa Status Memori)
Diterapkan pada layanan web server statis, mikroservis API RESTful, atau server DNS di mana setiap permintaan klien bersifat independen dan tidak bergantung pada status memori sesi sebelumnya. Failover stateless sangat cepat dan mudah diimplementasikan karena server sekunder hanya perlu menerima permintaan baru tanpa perlu mengetahui apa yang sedang dilakukan server primer sebelum mati.
2. Stateful Failover (Pengalihan Sesi Aktif Transaksional)
Diterapkan pada sistem yang menuntut kesinambungan sesi aktif secara mutlak—seperti sesi firewall enterprise, koneksi VPN IPSec, atau transaksi perbankan. Pada stateful failover, kedua server secara konstan menyinkronkan tabel status memori (state table synchronization) secara real-time melalui jaringan berkecepatan tinggi. Ketika failover terjadi, server sekunder telah memiliki salinan persis dari seluruh koneksi TCP dan sesi login pengguna yang sedang aktif, sehingga koneksi pengguna tidak terputus dan pengguna tidak perlu melakukan login ulang.
Proses Pemulihan: Mekanisme Failback dan Reintegrasi Node
Failover bukanlah akhir dari siklus penanganan bencana. Setelah teknisi perangkat keras selesai memperbaiki Node Primer (misalnya mengganti komponen yang rusak):
Sistem memasuki fase Failback, yakni proses mengembalikan beban kerja komputasi dari Node Sekunder kembali ke Node Primer:
– Sinkronisasi Data Mundur (Reverse Resynchronization): Seluruh data baru yang ditulis ke Node Sekunder selama masa insiden disalin kembali ke Node Primer agar kedua node memiliki data yang identik.
– Failback Anggun (Graceful Failback): Berbeda dengan failover yang terjadi secara darurat dan tiba-tiba, failback dijadwalkan pada waktu sepi pengunjung (misalnya tengah malam). Perangkat lunak kluster secara terencana mengalihkan kembali alamat IP dan layanan ke Node Primer dengan jeda waktu terkendali.
Kesimpulan
Failover server adalah jaring penyelamat paling vital dalam arsitektur komputasi awan dan pusat data modern. Dengan mengintegrasikan deteksi kegagalan berbasis detak jantung jaringan, protokol isolasi daya fisik STONITH yang tegas, migrasi alamat IP virtual tanpa jeda, serta sinkronisasi pangkalan data yang disiplin, mekanisme failover menjamin bahwa roda bisnis digital korporat dapat terus berputar tanpa henti di tengah segala skenario kegagalan perangkat keras fisik.
Penanganan Konsistensi Data: Sinkronisasi Replikasi Dua Fase (Two-Phase Commit)
Dalam sistem pangkalan data transaksional skala perbankan, salah satu tantangan paling kritis saat proses failover adalah memastikan bahwa tidak ada transaksi keuangan yang tercatat setengah-setengah di antara kedua server:
Untuk menjamin konsistensi ACID, arsitektur failover memanfaatkan protokol Two-Phase Commit (2PC):
Pada fase pertama (Prepare Phase), koordinator transaksi menanyakan kepada seluruh node apakah mereka siap menyimpan data baru. Setelah seluruh node memberikan konfirmasi persetujuan secara kriptografis, barulah koordinator memasuki fase kedua (Commit Phase), di mana data dituliskan secara permanen ke disk penyimpanan. Jika server primer mengalami kegagalan di tengah-tengah transaksi sebelum fase komit selesai, server sekunder yang mengambil alih failover akan secara otomatis membatalkan (rollback) transaksi tersebut, mencegah timbulnya data transaksi gantung yang dapat merusak saldo keuangan nasabah.
Dampak Failover Terhadap Koneksi Jaringan TCP/IP dan DNS Caching
Pengalihan beban kerja dari satu server ke server lain melibatkan penanganan lapisan transport jaringan yang sangat presisi:
Ketika server sekunder mengambil alih Virtual IP (VIP), koneksi TCP yang sedang aktif dari klien lama mungkin akan mengalami pemutusan mendadak (TCP RST). Namun, aplikasi modern enterprise dirancang dengan fitur Connection Pooling dan Auto-Reconnect Logic. Pustaka klien basis data (seperti JDBC atau OLEDB) akan secara otomatis mendeteksi pemutusan koneksi dan mencoba menyambung kembali ke alamat VIP yang sama dalam waktu 500 milidetik.
Bagi sistem yang mengandalkan pengalihan berbasis DNS (DNS Failover), nilai TTL (Time to Live) rekaman DNS harus disetel pada durasi yang sangat rendah (misalnya 10 hingga 30 detik). Hal ini memastikan bahwa peramban web pengguna dan server DNS perantara di seluruh dunia segera menghapus alamat IP server lama dari cache memori mereka dan mengarahkan lalu lintas data ke alamat server baru secara instan.
Peran Load Balancer dan Proksi Terbalik dalam Orkestrasi Failover
Dalam arsitektur komputasi awan modern, perangkat penyeimbang beban (Load Balancer) tingkat lanjut memegang peran sentral dalam mendeteksi dan mengeksekusi failover tanpa disadari oleh pengguna akhir:
Load balancer di garis depan (seperti NGINX Plus, HAProxy Enterprise, atau AWS Application Load Balancer) secara konstan mengirimkan pemeriksaan kesehatan sintetis (synthetic health probes) ke setiap node server di belakangnya setiap 2 detik. Pemeriksaan ini bukan sekadar tes ping ICMP sederhana, melainkan verifikasi fungsional HTTP/HTTPS tingkat aplikasi—seperti meminta endpoint /healthz yang memverifikasi koneksi database internal dan kapasitas memori server.
Jika server primer gagal merespons endpoint healthz dengan kode status HTTP 200 dalam batas waktu 1.000 milidetik, load balancer akan seketika menandai server tersebut sebagai status ‘Unhealthy’ dan menghentikan pengaliran koneksi baru ke server tersebut. Seluruh permintaan pengguna yang sedang berjalan akan secara transparan dialihkan ke server sekunder yang siaga, memberikan transisi failover yang mulus di tingkat lapisan aplikasi (Layer 7 Load Balancing).
Protokol Pengujian Bencana Berkala: GameDay dan Chaos Engineering
Memastikan mekanisme failover beroperasi dengan sempurna menuntut budaya pengujian proaktif di pusat data enterprise:
Perusahaan teknologi terkemuka menerapkan filosofi GameDay, di mana tim arsitek infrastruktur secara sengaja mensimulasikan kegagalan acak pada lingkungan produksi (menggunakan instrumen seperti Chaos Monkey). Pengujian ini memvalidasi apakah pengambilalihan Virtual IP, isolasi daya STONITH, dan pemulihan transaksi basis data benar-benar berjalan dalam rentang waktu SLA di bawah 30 detik. Dengan membiasakan sistem menghadapi kegagalan tiruan, tim IT dapat mendeteksi celah konfigurasi perangkat lunak sebelum bencana kegagalan perangkat keras fisik yang sebenarnya terjadi di dunia nyata.