Dalam operasional pusat data tingkat korporat, peladen (server) enterprise bertugas menjalankan beban komputasi kritis yang bernilai miliaran rupiah selama bertahun-tahun tanpa henti. Di dalam sasis server setebal 1U atau 2U, ribuan komponen elektronik beroperasi di bawah tekanan termal tinggi, aliran arus listrik puluhan ampere, dan getaran mekanis frekuensi tinggi dari putaran kipas pendingin. Dalam kondisi operasional yang sedemikian ekstrem, kerusakan perangkat keras bukanlah sebuah kemungkinan, melainkan sebuah kepastian statistik yang pasti akan terjadi seiring berjalannya waktu.
Namun, pernahkah Anda bertanya-tanya: bagaimana server enterprise mampu mendeteksi kerusakan perangkat keras secara mandiri, sering kali beberapa minggu sebelum komponen tersebut benar-benar mati total? Mengapa sebuah server dapat secara cerdas mengisolasi modul memori RAM yang mulai korup, mengalihkan beban daya dari PSU yang mengalami fluktuasi voltase, atau menyalakan lampu peringatan amber di laci hard disk tanpa memicu crash pada sistem operasi?
Kemampuan pertahanan mandiri ini merupakan hasil dari arsitektur telemetri perangkat keras berlapis yang mengombinasikan sensor fisik lingkungan, subsistem manajemen out-of-band independen (Baseboard Management Controller / BMC), logika diagnostik prosesor tingkat silikon (Machine Check Architecture), serta protokol pelaporan terstandarisasi industri. Memahami mekanisme deteksi kerusakan hardware ini sangat penting bagi setiap insinyur sistem untuk melakukan tindakan mitigasi proaktif sebelum terjadi bencana gangguan layanan (unplanned downtime).
Arsitektur Out-of-Band: Peran Sentral BMC dan Protokol IPMI/Redfish
Fondasi utama dari sistem pengawasan perangkat keras pada server enterprise terletak pada subsistem yang sepenuhnya terpisah dari sistem operasi utama, yang dikenal sebagai arsitektur out-of-band (OOB management):
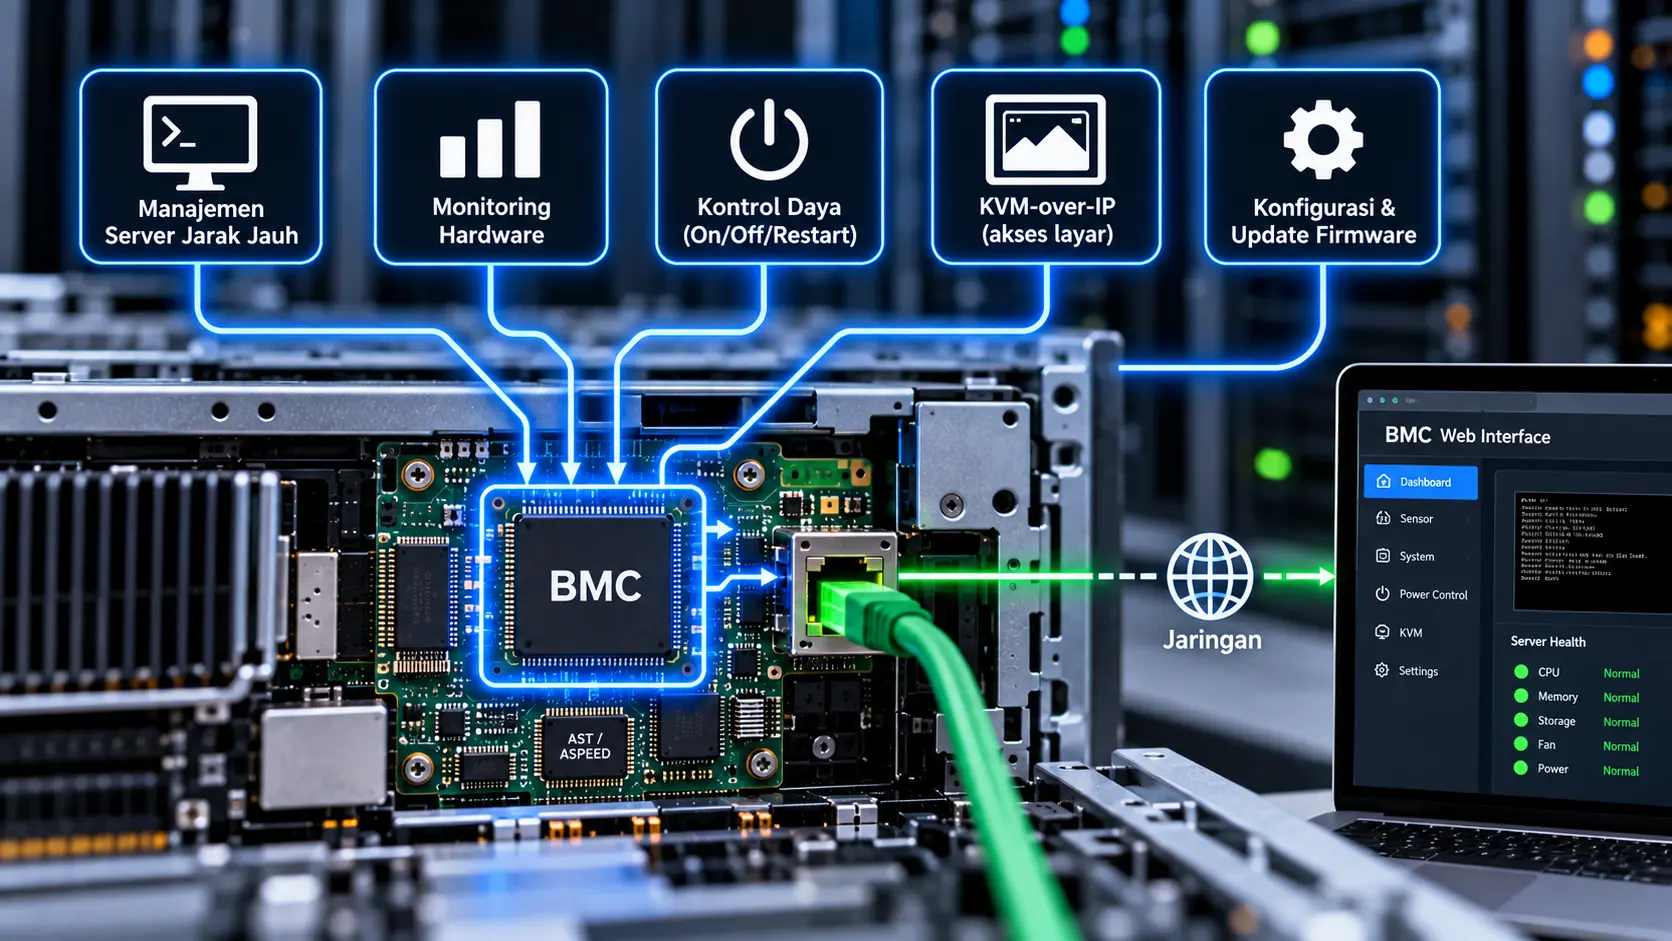
Di setiap motherboard server enterprise, terdapat sebuah prosesor mikro independen berbasis arsitektur ARM atau RISC yang disebut Baseboard Management Controller (BMC)—seperti Dell iDRAC, HPE iLO, atau Lenovo XClarity. BMC beroperasi dengan sistem operasi tertanam (embedded Linux) miliknya sendiri dan ditenagai oleh jalur daya siaga (standby power rail 3.3VSB / 5VSB). Hal ini berarti BMC telah aktif mengawasi perangkat keras sejak kabel listrik dicolokkan ke server, bahkan sebelum tombol power utama ditekan dan ketika sistem operasi utama dalam kondisi mati.
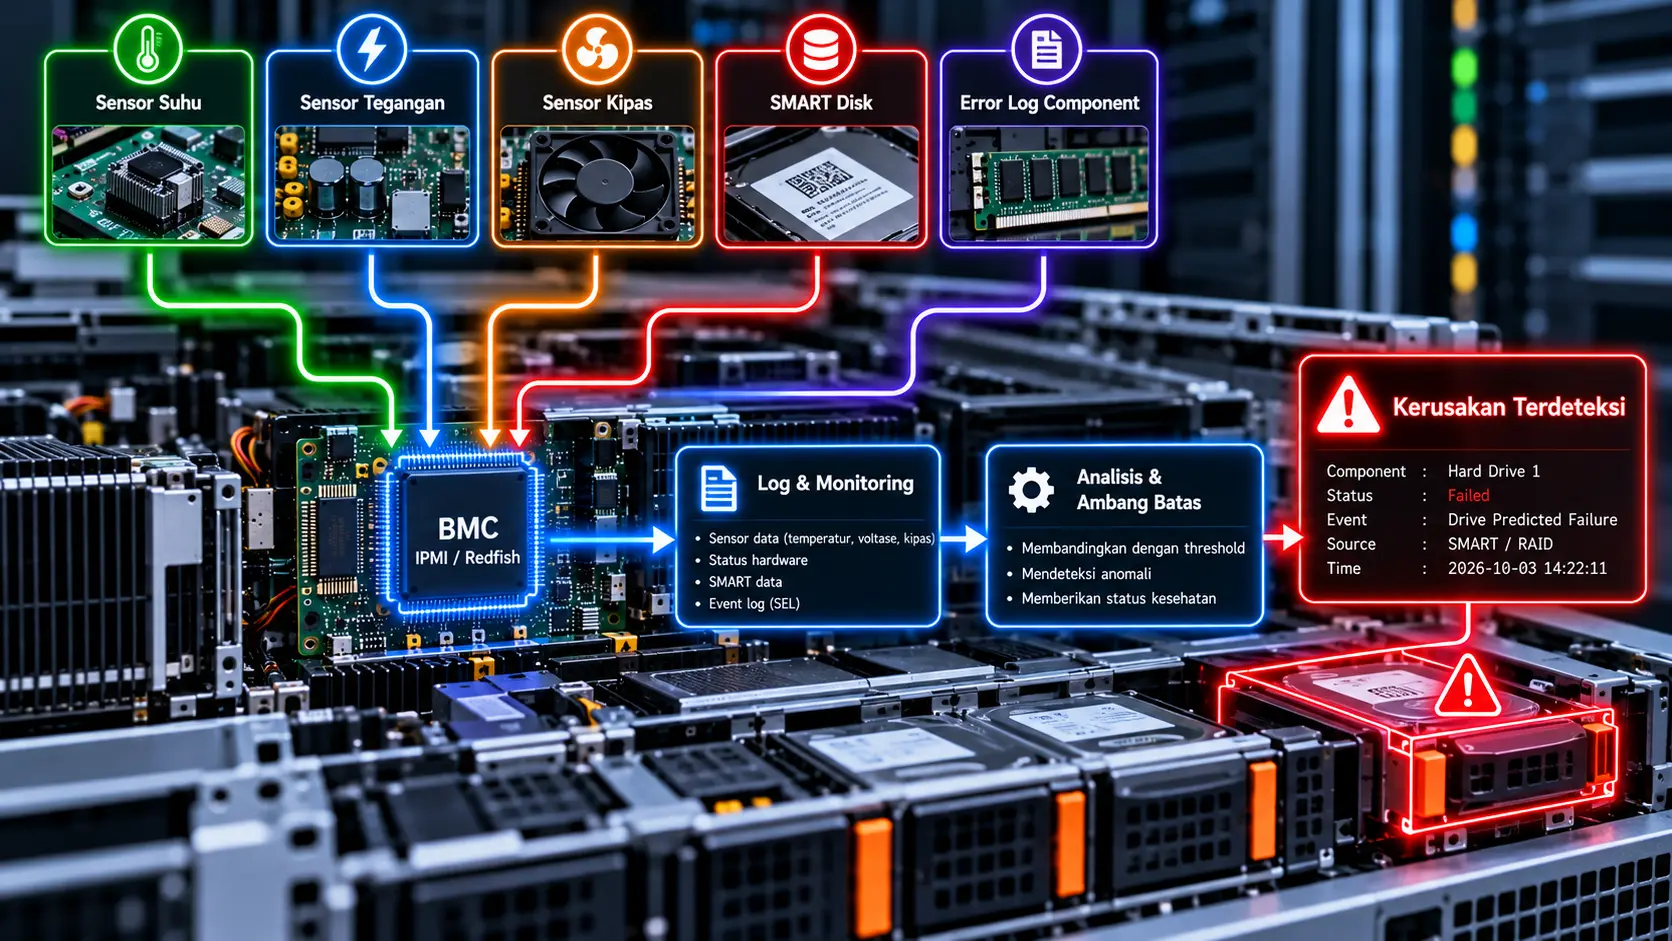
BMC terhubung ke ratusan sensor perangkat keras di seluruh motherboard melalui bus komunikasi serial kecepatan rendah seperti I2C (Inter-Integrated Circuit), SMBus (System Management Bus), dan PMBus. Menggunakan standar protokol industri IPMI (Intelligent Platform Management Interface) atau RESTful API modern berbasis Redfish, BMC memindai (polling) kondisi fisik seluruh subsistem vital setiap beberapa milidetik sekali:
– Sensor Termal (Thermal Probes): Puluhan termistor mikro mengukur suhu die silikon CPU, modul DIMM memori, chipset PCH, soket ekspansi PCIe, dan zona saluran udara masuk-keluar.
– Sensor Voltase (Voltage Rails): Memantau stabilitas tegangan DC utama (12V, 5V, 3.3V) serta tegangan inti logika prosesor (Vcore) dengan toleransi deviasi ketat di bawah 5 persen.
– Sensor Tachometer Kipas: Membaca pulsa rotasi per menit (RPM) dari setiap modul kipas sasis ganda (dual-rotor fan) untuk mendeteksi penurunan kecepatan akibat keausan bantalan poros motor.
Baca Juga: Apa Fungsi BMC pada Server? Arsitektur Out-of-Band, Manajemen IPMI, dan Keamanan KVM-over-IP
Deteksi Kegagalan Tingkat Silikon Mikroprosesor: Machine Check Architecture (MCA)
Ketika gangguan perangkat keras terjadi di tingkat komputasi inti—seperti kesalahan bit data di dalam register CPU atau cache L1/L2/L3—sistem operasi berbasis perangkat lunak sering kali terlalu lambat untuk merespon sebelum data korup menyebar. Untuk menangani hal ini, arsitektur prosesor enterprise modern (seperti x86-64 Intel dan AMD) mengintegrasikan sirkuit perangkat keras khusus yang disebut Machine Check Architecture (MCA):
1. Correctable Errors (Kesalahan yang Dapat Dikoreksi)
Ketika partikel kosmik radiasi alfa menabrak sel memori cache prosesor dan membalikkan nilai 1 bit (single-bit flip), sirkuit deteksi perangkat keras Error-Correcting Code (ECC) di dalam prosesor akan seketika memperbaiki bit tersebut menjadi nilai aslinya secara instan tanpa menghentikan komputasi. Namun, prosesor tidak mendiamkan insiden tersebut; sirkuit MCA mencatat alamat fisik sel memori yang bermasalah ke dalam register Machine Check Banks dan memicu interupsi SMI (System Management Interrupt) ke BMC untuk mencatat tren frekuensi kegagalan.
2. Uncorrectable Errors (Kesalahan Fatal Tak Terkoreksi)
Jika terjadi kerusakan fatal yang tidak dapat dipulihkan—misalnya kesalahan multi-bit (multi-bit parity error) atau kegagalan bus interkoneksi UPI/Infinity Fabric antar-soket CPU—prosesor akan langsung memicu Machine Check Exception (MCE). Untuk melindungi integritas pangkalan data korporat dari penulisan data yang korup ke media penyimpanan, MCE menginstruksikan prosesor untuk segera menghentikan eksekusi perintah (hardware halt) dan memicu kernel panic atau bugcheck biru (BSOD) secara terkendali sebelum kerusakan meluas.
Pengawasan Subsistem Memori: Predictive Failure Analysis (PFA) pada RAM ECC
Modul memori RAM adalah salah satu komponen yang paling sering mengalami degradasi di dalam server. Server enterprise menggunakan memori berspesifikasi Registered ECC (RDIMM atau LRDIMM) yang dilengkapi algoritma deteksi kegagalan prediktif (Predictive Failure Analysis / PFA):
Standar arsitektur server mengadopsi algoritma pemantauan ambang batas kesalahan (Error Threshold Monitoring). Setiap kali terjadi single-bit correctable error pada sebuah modul DIMM, mikrokontroler memori internal (iMC) menghitung laju kejadian per satuan waktu. Jika frekuensi kesalahan pada baris alamat memori tertentu melampaui ambang batas aman (misalnya terjadi 10 kesalahan koreksi per jam), firmware server menandai bahwa sel silikon pada chip DRAM tersebut sedang menuju ke arah kegagalan permanen (imminent multi-bit failure).
Pada server kelas atas, sistem dapat mengeksekusi fitur Memory Page Retirement atau Memory Rank Sparing. Sistem operasi atau hypervisor secara transparan memindahkan data dari blok memori yang rusak tersebut ke blok memori cadangan yang sehat, lalu mengisolasi blok yang rusak agar tidak dialokasikan kembali ke aplikasi. Bersamaan dengan itu, BMC mengirimkan notifikasi peringatan penggantian modul DIMM kepada administrator sebelum terjadi crash sistem.
Deteksi Dini Subsistem Penyimpanan: Telemetri SMART dan Enclosure Services
Penyimpanan data memiliki mekanisme deteksi mandiri yang sangat matang melalui integrasi protokol Self-Monitoring, Analysis and Reporting Technology (SMART) yang tertanam di dalam mikrokontroler internal setiap hard disk (HDD) dan SSD:
1. Parameter SMART Kritis pada Hard Disk Mekanis: Kontroler RAID secara berkala menanyai parameter SMART dari setiap disk drive. Peningkatan mendadak pada atribut ‘Reallocated Sectors Count’ (sektor fisik yang rusak dan dialihkan ke area cadangan), ‘Current Pending Sector Count’ (sektor tidak stabil yang menunggu pemetaan ulang), atau lonjakan nilai ‘Raw Read Error Rate’ mengindikasikan bahwa lapisan magnetik piringan atau jarum aktuator sedang mengalami kerusakan mekanis fisik.
2. Atribut Ketahanan SSD Flash: Pada media SSD enterprise, kontroler memantau parameter ‘Percentage Used Endurance Indicator’ (persentase usia pakai sel NAND berdasarkan siklus hapus-tulis TBW) dan ‘Media and Data Integrity Errors’. Jika kapasitas blok cadangan (spare blocks) SSD merosot di bawah 10 persen, sistem akan memberi peringatan bahwa SSD mendekati status baca-saja (read-only mode).
3. Isolasi Drive Melalui SGPIO / SES-2: Begitu kontroler RAID menyimpulkan bahwa sebuah drive tidak lagi memenuhi standar integritas data, kontroler akan mengeluarkan drive tersebut dari susunan array (marking drive as Failed/Offline), menyalakan lampu indikator amber fault LED di sasis drive bay melalui protokol backplane SES-2, dan memulai proses rebuild otomatis menggunakan drive cadangan siaga (Hot Spare) tanpa memerlukan campur tangan manusia.
Pencatatan Kronologis: System Event Log (SEL) dan Analisis Crash Dump
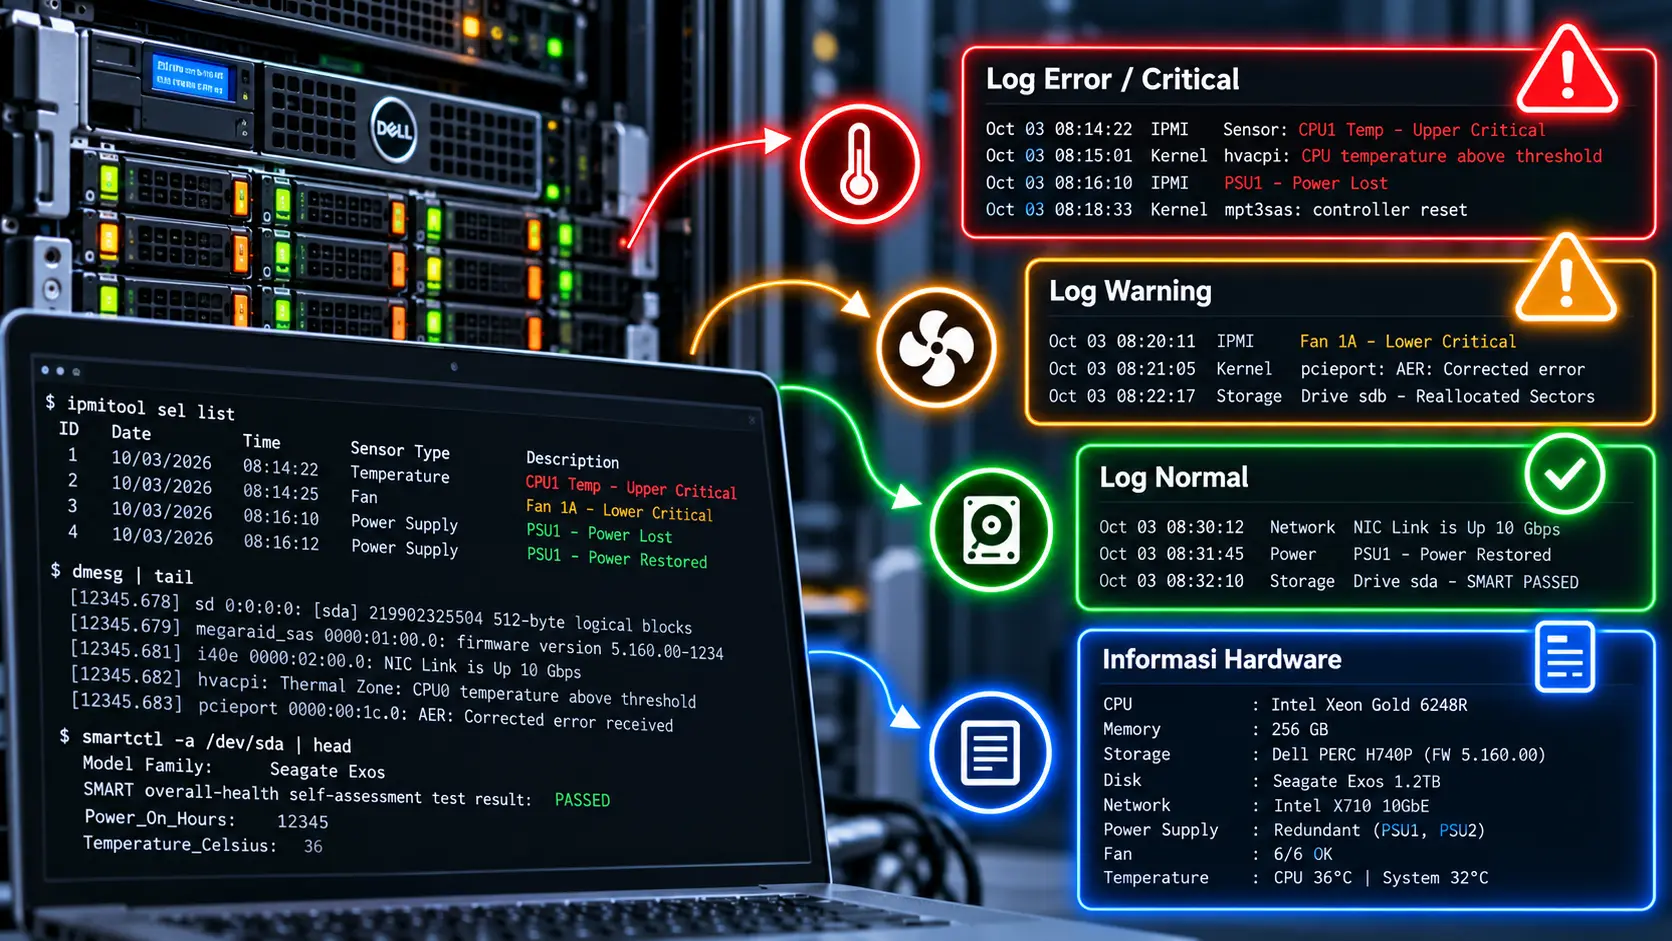
Seluruh deteksi anomali perangkat keras yang ditangkap oleh BMC, prosesor, dan kontroler periferal akan dikompilasi ke dalam repositori log non-volatile yang disebut System Event Log (SEL):
Setiap entri di dalam SEL dicatat dengan cap waktu presisi tinggi (timestamp), identitas sensor pelapor, kode tingkat keparahan (Informational, Warning, Critical), serta payload kode heksadesimal yang mengidentifikasi secara spesifik lokasi fisik komponen yang bermasalah (misalnya ‘DIMM B2’ atau ‘PCIe Slot 3’). Repositori SEL ini disimpan di dalam chip flash memori mandiri BMC yang tidak akan terhapus meskipun sistem operasi mengalami crash total atau motherboard kehilangan seluruh daya listrik.
Melalui antarmuka manajemen BMC atau protokol SNMP/Syslog terpusat, administrator dapat menelaah urutan peristiwa (sequence of events) detik demi detik yang memicu insiden perangkat keras, memungkinkan tim teknik melakukan diagnosis akar masalah (Root Cause Analysis / RCA) dan mengganti komponen yang tepat pada kesempatan pertama (First-Time Fix Rate).
Kesimpulan
Deteksi kerusakan perangkat keras pada server enterprise bukanlah proses reaktif yang menunggu sistem mati, melainkan sebuah simfoni rekayasa proaktif yang beroperasi 24 jam sehari di balik layar. Dari mikrokontroler BMC out-of-band yang memantau telemetri sensor analog, kecerdasan sirkuit Machine Check Architecture di dalam inti prosesor, algoritma mitigasi memori ECC prediktif, hingga analisis telemetri SMART penyimpanan data, arsitektur server dirancang untuk mendeteksi, mengisolasi, dan melaporkan setiap tanda kerapuhan fisik silikon demi mempertahankan integritas data dan ketersediaan layanan komputasi korporat di tingkat tertinggi.
Integrasi Platform AI dan Machine Learning untuk Predictive Hardware Analytics
Dalam evolusi pusat data komputasi awan skala hyperscale terkini, deteksi kerusakan perangkat keras tidak lagi hanya mengandalkan aturan ambang batas statis (threshold-based alerting). Pabrikan server enterprise modern kini mengintegrasikan kecerdasan buatan dan analitik berbasis awan (seperti Dell CloudIQ, HPE InfoSight, atau Lenovo XClarity Administrator):
Setiap detik, ribuan metrik telemetri resolusi tinggi—mulai dari fluktuasi arus fase daya, micro-burst temperatur prosesor, kecepatan respons I/O disk, hingga getaran kipas sasis—dikirimkan secara aman ke platform analitik berbasis awan. Algoritma pembelajaran mesin (Machine Learning) yang telah dilatih dengan data operasional jutaan server di seluruh dunia membandingkan pola perilaku telemetri server Anda dengan tanda-tanda kegagalan historis.
Melalui korelasi pola anomali tersembunyi (cross-telemetry pattern correlation), platform AI mampu memprediksi kegagalan komponen fisik hingga 30 hari sebelum sensor konvensional mendeteksi kerusakan. Ketika sebuah pola penurunan performa teridentifikasi, sistem bahkan dapat secara otomatis membuka tiket garansi ke pihak vendor penyedia suku cadang dan mengirimkan teknisi beserta komponen pengganti ke lokasi data center sebelum server Anda sempat mengalami penurunan performa.
Dengan menerapkan ekosistem diagnostik mandiri yang komprehensif ini, perusahaan dapat memangkas angka kejadian downtime tak terduga hingga lebih dari 80 persen, menjamin bahwa sistem komputasi bisnis selalu berjalan stabil, aman, dan beroperasi pada efisiensi puncak setiap saat.